چطور سیستمهای توزیعشده مقاوم به خطا بسازیم؟
برنامهنویسی مقاوم به خطا در محاسبات توزیعشده یا Fault-Tolerant Distributed Programming یکی از مهمترین مفاهیم در معماری نرمافزارهای مدرن است که تضمین میکند سیستم حتی در شرایط خرابی، قطعی شبکه یا از کار افتادن سرورها همچنان به کار خود ادامه دهد. در دنیایی که اغلب اپلیکیشنها مبتنی بر میکروسرویس، رایانش ابری و زیرساختهای مقیاسپذیر هستند، مقاومت در برابر خطا به یک الزام تبدیل شده است نه یک ویژگی اختیاری. اگر یک سیستم توزیعشده فاقد طراحی مقاوم به خطا باشد، کوچکترین اختلال میتواند کل سرویس را از دسترس خارج کند و خسارتهای مالی و اعتباری جدی ایجاد نماید.
محاسبات توزیعشده چیست و چرا به مقاومت در برابر خطا نیاز دارد؟
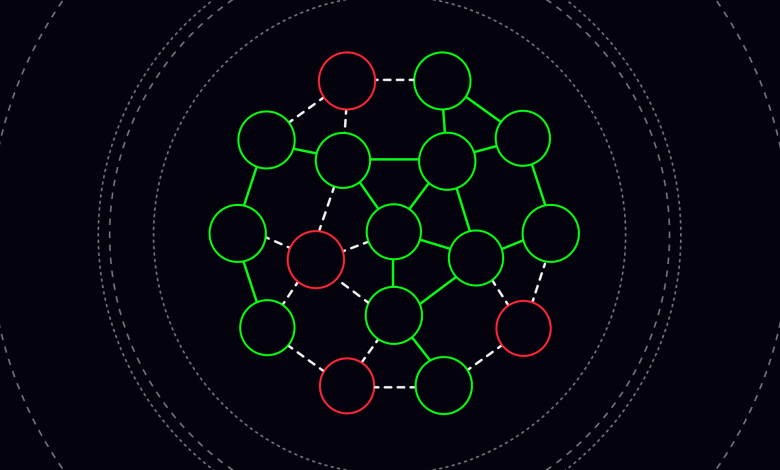
محاسبات توزیعشده به سیستمی گفته میشود که از چندین نود یا سرور مستقل تشکیل شده و این نودها از طریق شبکه با یکدیگر ارتباط برقرار میکنند تا یک هدف مشترک را دنبال کنند. در چنین ساختاری، احتمال خرابی سختافزار، تأخیر شبکه، ناسازگاری داده و حتی از دست رفتن پیامها کاملاً طبیعی است. برنامهنویسی مقاوم به خطا در محاسبات توزیعشده تلاش میکند این خرابیهای اجتنابناپذیر را پیشبینی کرده و مکانیزمهایی برای بازیابی خودکار و ادامه سرویس طراحی کند. بدون این رویکرد، سیستمهای بزرگ مقیاس به شدت شکننده و ناپایدار خواهند بود.
اصول کلیدی Fault-Tolerant Distributed Programming
یکی از اصول مهم در Fault-Tolerant Distributed Programming، فرض بر وقوع خطا است نه جلوگیری مطلق از آن. توسعهدهندگان باید سیستم را به گونهای طراحی کنند که خرابی یک سرویس یا نود باعث از کار افتادن کل سیستم نشود و فرآیندها بتوانند به صورت خودکار ریاستارت یا جایگزین شوند. استفاده از الگوهایی مانند Retry Mechanism، Circuit Breaker و Replication از جمله روشهای رایج برای افزایش تحمل خطا در سیستمهای توزیعشده است. این اصول کمک میکنند سیستم نه تنها پایدار بماند، بلکه در شرایط فشار و بار بالا نیز عملکرد قابل قبولی ارائه دهد.
نقش تکرارپذیری و Replication در مقاومت در برابر خطا
در برنامهنویسی مقاوم به خطا در محاسبات توزیعشده، تکرار دادهها و سرویسها نقش حیاتی دارد زیرا با ایجاد نسخههای متعدد از اطلاعات یا سرویسها، احتمال از دست رفتن کامل داده یا توقف سرویس کاهش مییابد. Replication به سیستم اجازه میدهد در صورت خرابی یک نود، نود دیگری مسئولیت را بر عهده بگیرد و کاربران اختلال محسوسی تجربه نکنند. البته این روش چالشهایی مانند هماهنگسازی دادهها و حفظ سازگاری را به همراه دارد که باید با استفاده از الگوریتمهای اجماع مانند Raft یا Paxos مدیریت شود. طراحی صحیح مکانیزمهای تکرارپذیری میتواند تفاوت بین یک سیستم پایدار و یک سیستم شکننده را رقم بزند.
مدیریت خطا و الگوهای طراحی در سیستمهای توزیعشده
الگوهای طراحی در برنامهنویسی مقاوم به خطا نقش کلیدی در کاهش ریسک خرابی دارند و به توسعهدهندگان کمک میکنند رفتار سیستم را در شرایط بحرانی پیشبینی کنند. استفاده از Timeoutهای منطقی، صفهای پیام پایدار، مانیتورینگ لحظهای و مکانیزمهای Health Check از جمله روشهایی هستند که در معماریهای مدرن مورد استفاده قرار میگیرند. علاوه بر این، ثبت لاگ دقیق و سیستمهای Observability به تیمهای فنی کمک میکنند سریعتر مشکلات را شناسایی و برطرف نمایند. بدون این ابزارها، عیبیابی در سیستمهای توزیعشده بسیار پیچیده و زمانبر خواهد بود.
چالشهای برنامهنویسی مقاوم به خطا در مقیاس بالا
با افزایش مقیاس سیستم، پیچیدگی Fault-Tolerant Distributed Programming نیز به شکل چشمگیری افزایش پیدا میکند زیرا تعداد تعاملات بین سرویسها بیشتر شده و احتمال بروز شرایط پیشبینینشده بالا میرود. مسئله Consistency در کنار Availability یکی از چالشهای اساسی است که با قضیه CAP شناخته میشود و توسعهدهندگان باید بین این ویژگیها تعادل برقرار کنند. همچنین تست کردن سناریوهای خرابی در محیطهای واقعی نیازمند ابزارهای Chaos Engineering و شبیهسازی خطا است تا نقاط ضعف سیستم قبل از وقوع بحران شناسایی شوند. مدیریت این چالشها نیازمند تجربه، دانش معماری و استفاده از ابزارهای مدرن است.
آینده Fault-Tolerant Distributed Programming در معماری ابری
با رشد رایانش ابری و معماریهای مبتنی بر کانتینر و Kubernetes، اهمیت برنامهنویسی مقاوم به خطا در محاسبات توزیعشده بیش از گذشته شده است. سیستمهای مدرن باید بتوانند به صورت خودکار مقیاسپذیر باشند، نودهای جدید اضافه کنند و در صورت خرابی، بدون دخالت انسانی بازیابی شوند. استفاده از زیرساخت به عنوان کد و اتوماسیون پیشرفته باعث شده طراحی سیستمهای مقاوم به خطا سادهتر اما در عین حال پیچیدهتر از نظر مفهومی شود. آینده توسعه نرمافزار بدون درک عمیق از Fault-Tolerant Distributed Programming قابل تصور نیست و این مهارت به یکی از پایههای اصلی مهندسی نرمافزار مدرن تبدیل خواهد شد.
جمعبندی
برنامهنویسی مقاوم به خطا در محاسبات توزیعشده یک ضرورت حیاتی برای سیستمهای مدرن است که بر پایه شبکه و معماریهای ابری ساخته شدهاند. این رویکرد با پذیرش وقوع خطا و طراحی مکانیزمهای بازیابی خودکار، پایداری و دسترسپذیری سیستم را تضمین میکند. توسعهدهندگانی که به دنبال ساخت نرمافزارهای مقیاسپذیر و قابل اعتماد هستند، باید اصول Fault-Tolerant Distributed Programming را به صورت عمیق درک کرده و در معماری پروژههای خود به کار ببرند. آینده فناوری متعلق به سیستمهایی است که نه تنها سریع و هوشمند هستند، بلکه در برابر خطا نیز مقاوم و پایدار عمل میکنند.