چرا پایتون برای I/O سریعتر از CPU-bound است؟
پایتون یکی از محبوبترین زبانهای برنامه نویسی در دنیای امروز است که بهخاطر سادگی، اکوسیستم غنی و قابلیتهای سریع توسعه شناخته میشود. با این حال، وقتی پای پرفورمنس و پردازشهای سنگین به میان میآید، این زبان رفتار متفاوتی از خود نشان میدهد. Python در انجام عملیات I/O مانند خواندن و نوشتن فایلها، درخواستهای شبکه یا تعامل با دیتابیس، کارایی مناسبی دارد و میتواند به صورت همزمان چندین Task را مدیریت کند. اما در پردازشهای CPU-bound، مثل محاسبات عددی سنگین یا الگوریتمهای پیچیده، Python به دلیل محدودیت Global Interpreter Lock (GIL) نمیتواند به شکل موازی از چندین هسته CPU بهره ببرد و همین باعث کاهش پرفورمنس در این سناریوها میشود.
GIL؛ محدودیت همزمانی CPU-bound
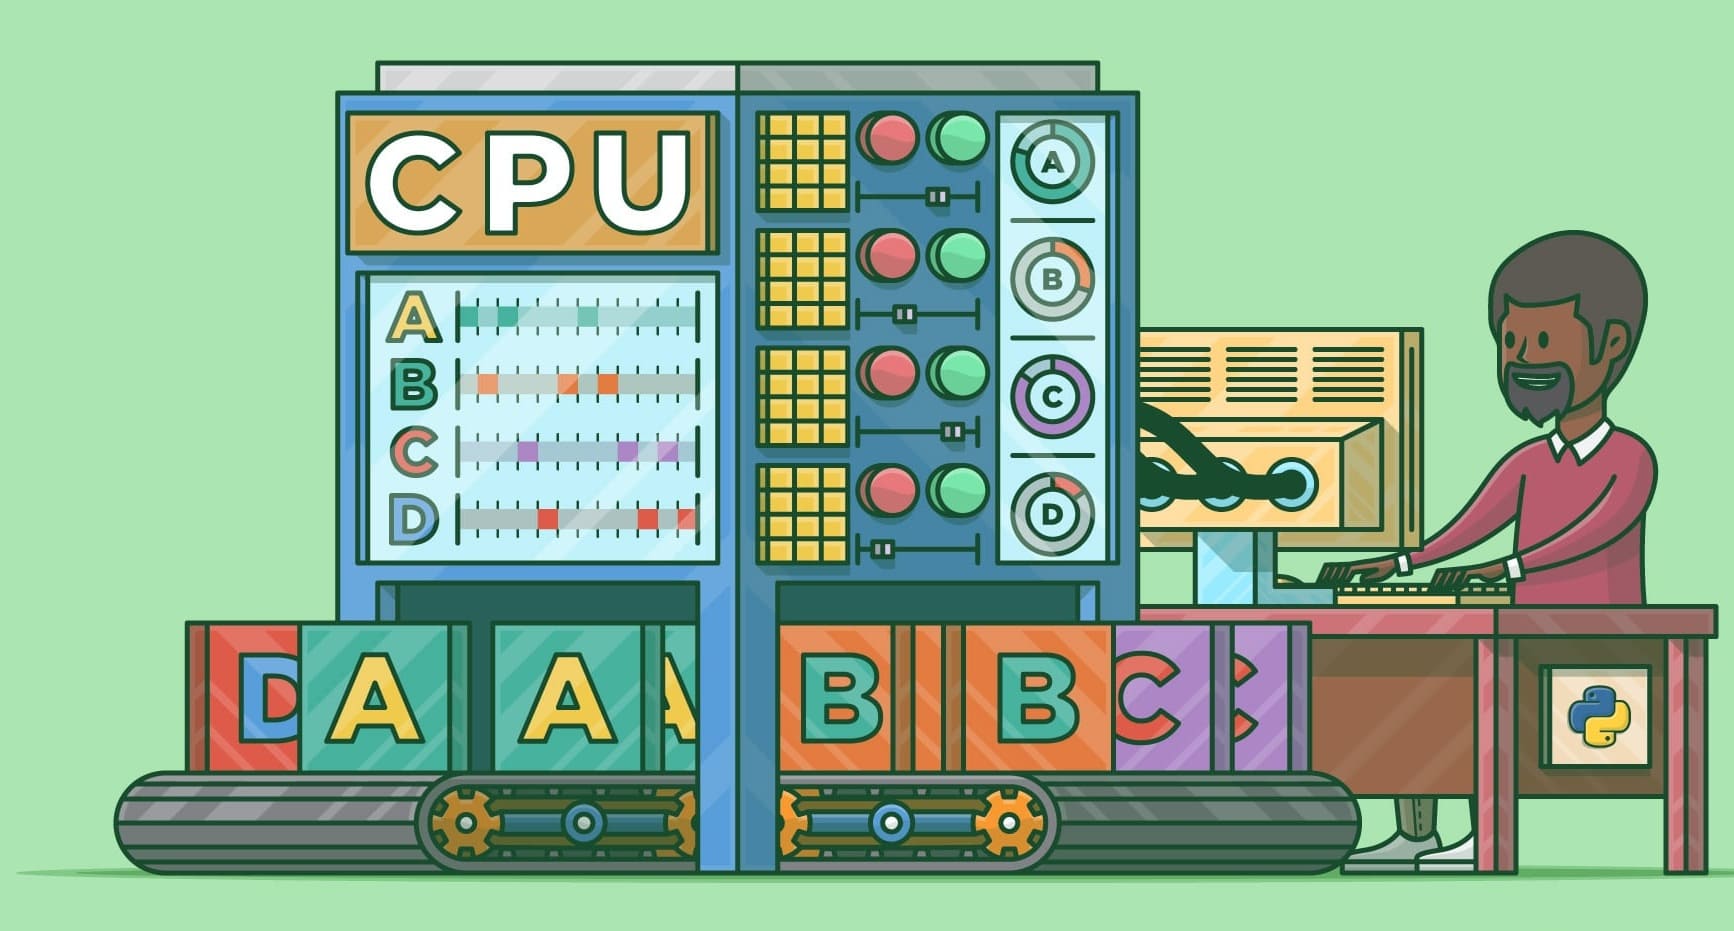
Global Interpreter Lock یا GIL یکی از ویژگیهای ذاتی CPython است که اجرای همزمان چند Thread در یک پروسه را کنترل میکند. به عبارت ساده، حتی اگر برنامه چند Thread داشته باشد، فقط یکی از آنها میتواند در یک لحظه کد Python را اجرا کند. این محدودیت باعث میشود CPU-bound Taskها نتوانند بهطور کامل از چند هسته بهره ببرند و پرفورمنس محدود شود. بنابراین، توسعهدهندگان باید برای محاسبات سنگین از Process-based Parallelism یا زبانهای دیگر با قابلیت Threading واقعی استفاده کنند. در مقابل، I/O-bound Taskها از این محدودیت عبور میکنند، زیرا Threadها در زمان انتظار برای I/O آزاد میشوند و سایر Taskها اجرا میشوند.
مدل async و Event Loop
یکی از دلایل سرعت Python در I/O، پشتیبانی از مدل asynchronous و Event Loop است که به کمک کتابخانههایی مثل asyncio، Tornado و FastAPI ارائه میشود. در این مدل، برنامه میتواند چندین عملیات I/O را بهصورت غیرمسدودکننده مدیریت کند. وقتی یک Task منتظر پاسخ شبکه یا دیتابیس است، Event Loop میتواند سایر Taskها را اجرا کند و در نتیجه بهرهوری بالاتر میرود. این ویژگی به ویژه در سرویسهای وب، APIهای پراستفاده و پردازش جریانهای دادهای، مزیت عملی و محسوس ایجاد میکند.
کتابخانهها و C-extensionها
Python در حوزه محاسبات سنگین معمولاً کند است، اما بسیاری از کتابخانههای مشهور مانند NumPy، Pandas و TensorFlow از C-extensionها استفاده میکنند. این کتابخانهها با اجرای عملیات در کد Native و خارج از GIL، امکان محاسبات سریع را فراهم میکنند. اما برای Taskهای معمولی CPU-bound که در pure Python نوشته میشوند، محدودیت GIL و اجرای Single-threaded باعث میشود سرعت به مراتب پایینتر از I/O-bound Taskها باشد. این تفاوت زیرساختی، علت اصلی رفتار متفاوت Python در دو نوع عملیات است.
تفاوت رفتار با Thread و Process
برای CPU-bound، راهکار رایج استفاده از Multiprocessing است که با ایجاد چند Process مستقل، هر کدام با GIL جداگانه، امکان استفاده از چند هسته فراهم میشود. در مقابل، برای I/O-bound، Threading کافی است و بدون نیاز به Processهای سنگین، Taskها همزمان اجرا میشوند. این تفاوت نشان میدهد که زیرساخت Python و GIL بهینهسازی شده برای I/O است و نه محاسبات سنگین، که توسعهدهندگان باید هنگام طراحی سیستمهای بزرگ این موضوع را در نظر بگیرند.
مدیریت حافظه و زمانبندی
در عملیات I/O، Python با استفاده از Event Loop و Non-blocking I/O میتواند حافظه را بهینه مدیریت کند و از Block شدن Threadها جلوگیری کند. در CPU-bound، به دلیل اجرای Single-threaded و اشغال هستهها توسط GIL، Garbage Collector و زمانبندی Taskها میتواند باعث تأخیر و کاهش پرفورمنس شود. بنابراین، رفتار حافظه و زمانبندی Taskها نیز یکی از عوامل مهم در سرعت اجرای I/O نسبت به CPU-bound است.
مزایا و محدودیتهای عملی
مزیت I/O سریع در Python باعث شده این زبان انتخاب اول برای توسعه سرویسهای وب، APIها و پردازش دادههای شبکهای باشد. اما محدودیت در CPU-bound باعث میشود پروژههای محاسباتی سنگین مانند شبیهسازیهای علمی یا الگوریتمهای پیچیده، نیازمند بهینهسازی یا مهاجرت به زبانهای سطح پایینتر باشند. این تفاوت عملی، نتیجه ترکیبی از GIL، مدل Event Loop و اجرای Single-threaded است.
جمعبندی: Python برای I/O ساخته شده است
Python با سادگی و قابلیتهای asynchronous، برای Taskهای I/O بسیار مناسب است و میتواند همزمان چندین عملیات شبکه و فایل را مدیریت کند. محدودیت GIL و اجرای Single-threaded باعث میشود که برای محاسبات سنگین CPU-bound، سرعت به مراتب کمتر باشد. درک این تفاوت زیرساختی، کلید طراحی سیستمهای بهینه و انتخاب درست معماری در پروژههای Python است.