چگونه الگوریتمهای بهینهسازی داده باعث کاهش مصرف منابع میشوند؟
در دنیای امروز که حجم دادهها به شکل تصاعدی در حال افزایش است، مدیریت مؤثر و بهینهسازی دادهها به یکی از چالشهای حیاتی توسعه نرمافزار تبدیل شده است. الگوریتمهای بهینهسازی دادهها نه تنها باعث افزایش سرعت پردازش میشوند، بلکه به کاهش مصرف منابع سیستم مانند حافظه، CPU و پهنای باند نیز کمک میکنند. بدون استفاده از این الگوریتمها، سیستمهای بزرگ و پردازشهای سنگین میتوانند به سرعت با مشکلات پرفورمنس و مقیاسپذیری مواجه شوند. این مقاله به بررسی نحوه عملکرد این الگوریتمها، تاثیر آنها بر منابع سیستم و روشهای عملی پیادهسازی آنها میپردازد.
الگوریتمهای فشردهسازی داده و کاهش مصرف حافظه
یکی از رایجترین تکنیکها برای کاهش مصرف منابع، استفاده از الگوریتمهای فشردهسازی داده است. الگوریتمهایی مانند Huffman، LZ77 و Brotli قادرند حجم دادههای ذخیرهشده و منتقلشده را به شکل چشمگیری کاهش دهند. این کاهش حجم داده باعث میشود حافظه مورد نیاز برای نگهداری دادهها کمتر شود و پهنای باند شبکه نیز بهینه گردد. در سیستمهای Real-Time و سرویسهای با حجم تراکنش بالا، استفاده از این الگوریتمها میتواند باعث کاهش Latency و افزایش Throughput شود. علاوه بر این، الگوریتمهای فشردهسازی با طراحی هوشمندانه، امکان پردازش مستقیم دادههای فشرده بدون نیاز به Decompress کامل را فراهم میکنند که این موضوع خود صرفهجویی در CPU و زمان را به همراه دارد.
ساختارهای داده بهینه و کاهش Overhead
انتخاب ساختار داده مناسب نقش حیاتی در بهینهسازی منابع ایفا میکند. برای مثال، استفاده از HashMap به جای List برای جستجوی دادهها میتواند زمان پردازش را به شکل چشمگیری کاهش دهد و با کاهش تعداد عملیات روی حافظه، مصرف CPU و Cache Missها را کاهش دهد. الگوریتمهای بهینهسازی داده اغلب با استفاده از تکنیکهای خاصی مانند Spatial Locality و Temporal Locality، دسترسی به حافظه را بهینه میکنند و از Fragmentation جلوگیری میکنند. این موضوع در پروژههای بزرگ که حجم دادهها و تعداد دسترسیها زیاد است، تاثیر مستقیم بر پرفورمنس و مصرف منابع دارد.
پردازش موازی و تقسیم دادهها
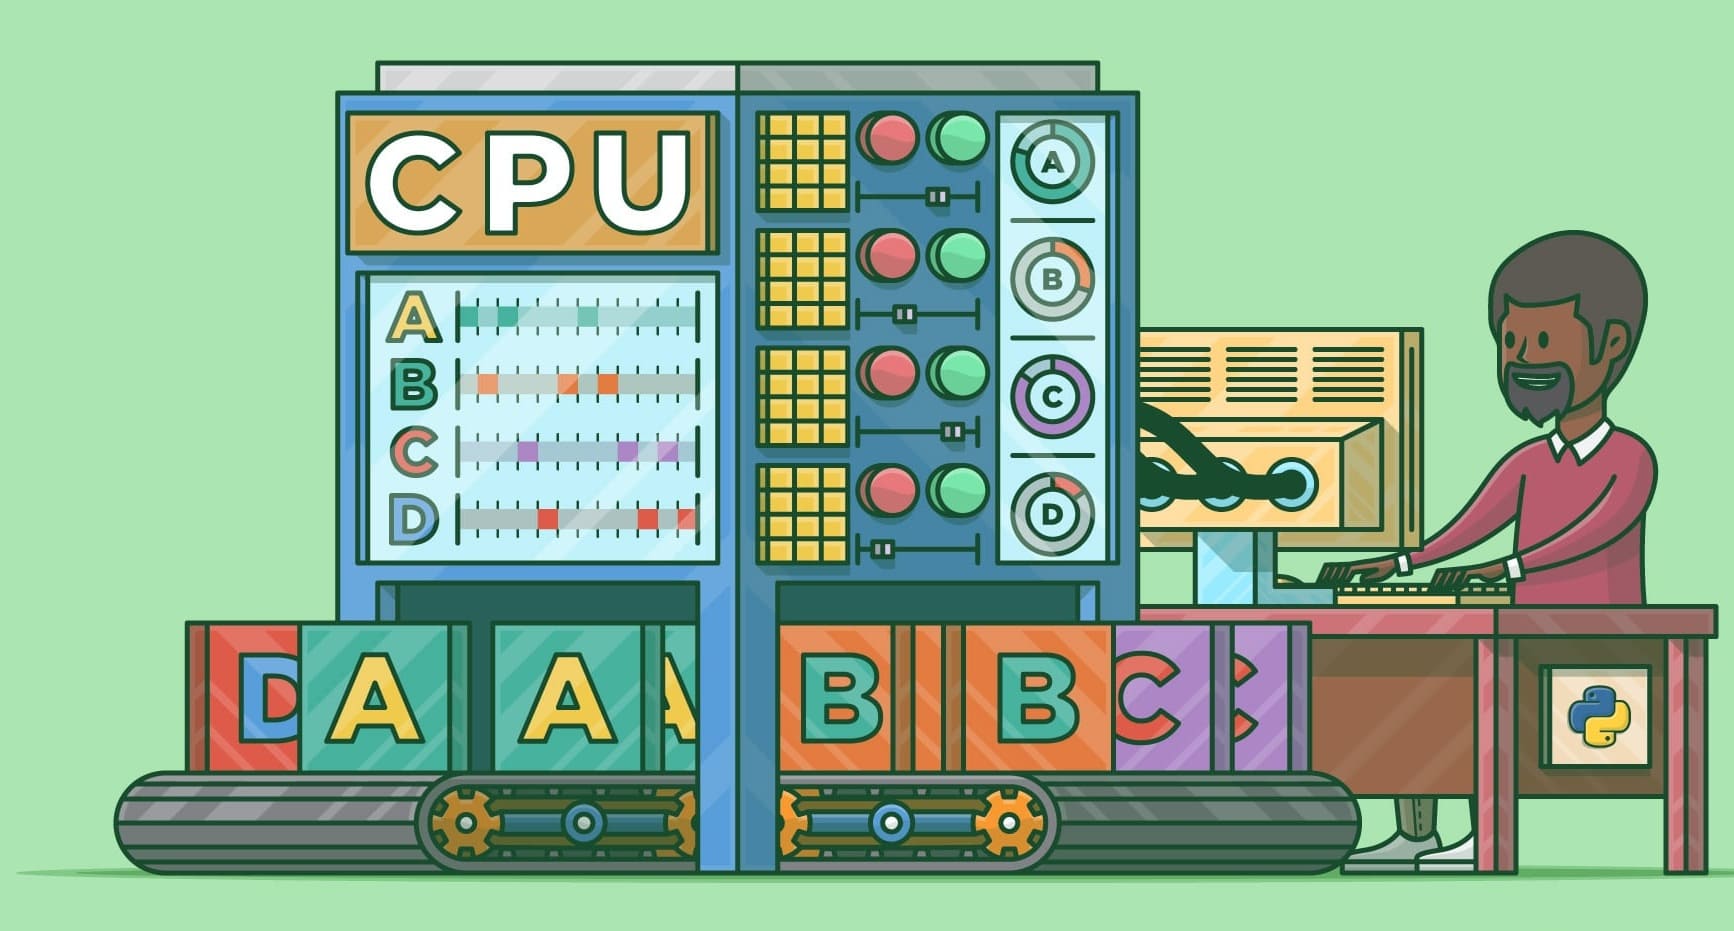
یکی دیگر از رویکردهای مهم، تقسیم دادهها و پردازش موازی است. الگوریتمهایی که دادهها را به بخشهای کوچکتر تقسیم کرده و به صورت همزمان روی Threadها یا Workerهای مختلف پردازش میکنند، باعث کاهش زمان کل پردازش و کاهش بار روی یک Thread واحد میشوند. این تکنیک در پروژههای High-Performance، Big Data و پردازش Streamها بسیار کاربردی است و با کاهش Bottleneckهای پردازشی، مصرف منابع سیستم به شکل بهینه توزیع میشود. همچنین با استفاده از الگوریتمهای Parallel و Concurrent، امکان استفاده بهتر از Cache و Memory Hierarchy فراهم میشود که خود باعث صرفهجویی در منابع میشود.
الگوریتمهای انتخابی و کاهش عملیات غیرضروری
بهینهسازی دادهها تنها به فشردهسازی و ساختارهای داده محدود نمیشود؛ الگوریتمهای انتخابی و Filtering نیز نقش مهمی دارند. برای مثال، الگوریتمهای Bloom Filter و MinHash قادرند بدون نیاز به پردازش کامل مجموعه دادهها، وجود یا شباهت دادهها را تشخیص دهند. این روشها باعث کاهش تعداد عملیات و دسترسی به حافظه میشوند و در نتیجه مصرف منابع را کاهش میدهند. در سیستمهایی که نیاز به تحلیل سریع دادههای بزرگ دارند، استفاده از این الگوریتمها به شکل چشمگیری زمان و منابع مصرفی را کاهش میدهد.
تاثیر بر مصرف انرژی و پایداری سیستم
بهینهسازی دادهها نه تنها باعث کاهش مصرف حافظه و CPU میشود، بلکه تاثیر مستقیم بر مصرف انرژی و پایداری سیستم دارد. در دیتاسنترها و سیستمهای Cloud، هر کاهش در پردازش و حافظه به کاهش انرژی مصرفی و هزینه عملیاتی منجر میشود. الگوریتمهای بهینهسازی داده با کاهش تعداد Read/Writeها، کاهش Cache Miss و کاهش Latency، به افزایش پایداری سیستم کمک میکنند و از بروز Bottleneck و Crash در پروژههای بزرگ جلوگیری میکنند. این موضوع به ویژه در سیستمهای Edge و IoT با منابع محدود اهمیت حیاتی دارد.
جمعبندی: الگوریتمهای داده کلید بهرهوری منابع
استفاده از الگوریتمهای بهینهسازی داده ترکیبی از فشردهسازی، ساختارهای داده بهینه، پردازش موازی و الگوریتمهای انتخابی است که باعث کاهش مصرف منابع، افزایش سرعت پردازش و بهبود پایداری سیستم میشوند. توسعهدهندگان حرفهای با درک دقیق این الگوریتمها و انتخاب مناسب آنها برای سناریوی پروژه خود، میتوانند سیستمهایی بسازند که هم سریع، هم پایدار و هم کممصرف باشند. این رویکرد به ویژه در پروژههای Big Data، High-Performance و Real-Time اهمیت حیاتی دارد و یکی از فاکتورهای کلیدی موفقیت سیستم محسوب میشود.